Lọc dữ liệu nhiễu (outlier/bad tick)
Quy trình nhận diện và xử lý các bản ghi giá bất thường (outlier/bad tick) trong dữ liệu lịch sử — do lỗi kỹ thuật khi truyền/ghi nhận dữ liệu hoặc do biến động thị trường cực đoan có thật — trước khi đưa dữ liệu vào chuỗi hợp đồng liên tục dùng cho backtest.
Outlier (hay bad tick) là điểm dữ liệu giá bất thường do lỗi ghi nhận, truyền tải hoặc xử lý kỹ thuật — khác với biến động giá thật do cung-cầu thị trường. Lọc dữ liệu nhiễu là bước loại bỏ các điểm lỗi này trước khi dùng dữ liệu để backtest, nhưng cần thận trọng để không loại nhầm biến động thật.
Định nghĩa đầy đủ
Lọc dữ liệu nhiễu (outlier/bad tick) là quá trình phát hiện và xử lý các điểm dữ liệu giá bất thường do lỗi kỹ thuật (ghi nhận sai, trùng lặp, giá trị phi thực tế) trong bộ dữ liệu lịch sử VN30F1M, nhằm đảm bảo dữ liệu dùng để backtest phản ánh đúng biến động thị trường thật, không bị nhiễu bởi lỗi hệ thống.
Những điều cần nhớ
- Outlier/bad tick phát sinh từ lỗi kỹ thuật (ghi nhận, truyền tải), không phản ánh cung-cầu thị trường thật
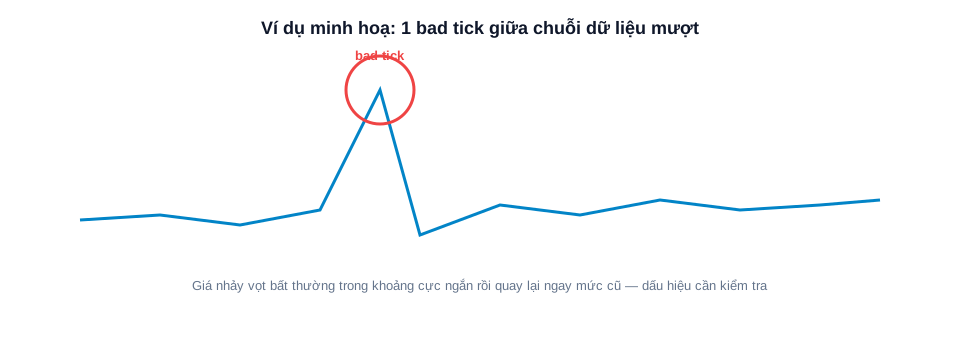
- Dấu hiệu thường gặp: giá nhảy vọt bất thường trong khoảng cực ngắn rồi quay lại ngay, hoặc vượt xa biên độ dao động hợp lệ
- Loại bỏ nhầm một biến động giá thật (coi là outlier) có thể làm mất tín hiệu, gây sai lệch kết quả backtest
- Giữ lại nhầm một bad tick thật cũng khiến chiến lược "phản ứng" với mức giá chưa từng thực sự tồn tại
- Lọc dữ liệu nhiễu thường thực hiện sau bước thu thập và trước bước ghép chuỗi hợp đồng liên tục
Outlier/bad tick khác biến động giá thật ở điểm nào
Biến động giá thật phản ánh sự thay đổi cung-cầu thực sự của thị trường tại một thời điểm — có thể mạnh hoặc nhẹ, nhưng luôn có cơ sở giao dịch thật đứng sau. Outlier/bad tick thì ngược lại: đây là sản phẩm của lỗi kỹ thuật trong chuỗi truyền tải và ghi nhận dữ liệu — ví dụ lỗi tại nguồn cấp dữ liệu, lỗi khi hợp nhất dữ liệu từ nhiều máy chủ, hoặc lỗi làm tròn/chuyển đổi định dạng. Điểm mấu chốt để phân biệt hai loại này không nằm ở độ lớn của biến động, mà ở việc mức giá đó có thật sự phát sinh từ một giao dịch hợp lệ trên thị trường hay không.
Các dấu hiệu thường gặp để nhận biết bad tick
Một số dấu hiệu phổ biến giúp khoanh vùng nghi ngờ bad tick: giá nhảy vọt bất thường trong một khoảng thời gian cực ngắn (ví dụ một vài giây) rồi lập tức quay lại mức trước đó ngay ở bản ghi kế tiếp; giá trị vượt xa biên độ dao động hợp lệ đã công bố cho phiên giao dịch; hoặc một bản ghi bị trùng lặp/thiếu timestamp hợp lý so với các bản ghi liền kề. Không có dấu hiệu nào tự nó là bằng chứng tuyệt đối — mỗi trường hợp nghi ngờ nên được đối chiếu thêm với dữ liệu từ nguồn khác hoặc bối cảnh thị trường tại đúng thời điểm đó trước khi quyết định loại bỏ.
| Đặc điểm | Biến động giá thật | Outlier/bad tick |
|---|---|---|
| Nguồn gốc | Giao dịch thật trên thị trường | Lỗi ghi nhận/truyền tải kỹ thuật |
| Hình dạng điển hình | Có thể mạnh nhưng có xu hướng hợp lý | Nhảy vọt rồi quay lại ngay tức thì |
| Cách xử lý | Giữ nguyên trong dữ liệu | Cần kiểm tra và có thể loại bỏ |
Bảng minh hoạ đặc điểm phân biệt khái niệm, không phải kết quả kiểm tra dữ liệu thật.
Ví dụ minh hoạ: một tick ghi nhận giá giảm đột ngột 50 điểm trong vòng 1 giây rồi quay lại mức cũ ngay ở tick kế tiếp (số liệu minh hoạ mô tả dấu hiệu bad tick, không phải dữ liệu thật) — đây là dấu hiệu cần kiểm tra kỹ trước khi quyết định loại bỏ hay giữ lại bản ghi đó.
Rủi ro khi lọc nhầm hoặc bỏ sót dữ liệu nhiễu
Cả hai hướng sai đều có chi phí. Nếu lọc quá tay và loại bỏ nhầm một biến động giá thật (ví dụ phản ứng thật của thị trường trước một tin tức bất ngờ), chiến lược backtest trên dữ liệu đã lọc có thể bỏ lỡ đúng giai đoạn quan trọng nhất để kiểm tra độ bền của mình. Ngược lại, nếu bỏ sót một bad tick thật và giữ nguyên trong dữ liệu, chiến lược có thể "phản ứng" với một mức giá chưa từng thực sự tồn tại — ví dụ kích hoạt một tín hiệu vào lệnh giả tại đúng điểm lỗi đó, khiến kết quả kiểm định trông khả quan hoặc bi quan hơn thực tế một cách không chính xác.
Lọc dữ liệu nhiễu nằm ở bước nào trong quy trình chuẩn bị dữ liệu
Về trình tự xử lý, lọc dữ liệu nhiễu thường được thực hiện ngay sau khi thu thập dữ liệu thô từ nguồn dữ liệu lịch sử, và trước khi ghép nối thành chuỗi hợp đồng liên tục phục vụ backtest. Thứ tự này có lý do rõ ràng: nếu để một bad tick lọt qua tới bước ghép chuỗi, nó có thể bị hiểu nhầm thành một khoảng nhảy giá liên quan tới điểm roll, khiến việc chẩn đoán lỗi phức tạp hơn nhiều so với xử lý ngay tại bước dữ liệu thô ban đầu. Bước này nên nằm trong cùng một quy trình với checklist chất lượng dữ liệu lịch sử VN30F1M trước khi đưa dữ liệu vào kiểm định chiến lược.
Câu hỏi thường gặp
Làm sao phân biệt bad tick với một cú sốc giá thật do tin tức?
Cần đối chiếu với các nguồn dữ liệu khác hoặc tin tức thị trường tại đúng thời điểm. Nếu không có sự kiện nào giải thích được mức biến động và giá quay lại ngay lập tức, khả năng cao đây là lỗi dữ liệu chứ không phải biến động thật.
Có công thức cố định nào để tự động lọc outlier không?
Có nhiều phương pháp thống kê phổ biến, ví dụ dựa trên độ lệch chuẩn hoặc biên độ hợp lý. Tuy nhiên không có công thức nào đúng tuyệt đối cho mọi trường hợp — nên kết hợp kiểm tra thủ công với các trường hợp nghi ngờ.
Bad tick có phổ biến trong dữ liệu tick tần suất cao không?
Có xu hướng phổ biến hơn ở dữ liệu tick tần suất cao, do khối lượng bản ghi lớn và nhiều điểm truyền tải kỹ thuật hơn so với dữ liệu theo phiên hoặc theo ngày.
Lọc dữ liệu nhiễu có cần làm lại mỗi khi backtest không?
Không cần làm lại mỗi lần nếu dữ liệu gốc không đổi. Nhưng cần làm lại khi cập nhật thêm dữ liệu mới hoặc khi đổi sang nguồn dữ liệu khác.
Bỏ qua bước lọc dữ liệu nhiễu có ảnh hưởng nghiêm trọng không?
Có thể ảnh hưởng đáng kể, đặc biệt với chiến lược nhạy cảm với biến động giá ngắn hạn hoặc dựa trên các mức giá cực trị, vì loại chiến lược này dễ "phản ứng" sai với dữ liệu lỗi hơn các chiến lược khác.
Lọc dữ liệu nhiễu có liên quan gì tới việc đổi mã hợp đồng theo hệ thống KRX không?
Có liên quan gián tiếp — cả hai đều là loại lỗi dữ liệu cần xử lý trước khi ghép chuỗi liên tục. Xem thêm bài mã hợp đồng theo hệ thống KRX là gì để hiểu một nguyên nhân khác cũng có thể gây đứt/lệch dữ liệu ở mốc chuyển đổi hệ thống.
Lưu ý rủi ro: Nội dung trên đây là để tham khảo mô tả quy trình xử lý dữ liệu, không phải khuyến nghị đầu tư. Chứng khoán phái sinh dùng đòn bẩy — lãi và lỗ đều được khuếch đại.
Xem thêm bài nguồn dữ liệu lịch sử VN30F1M là gì và lọc dữ liệu nhiễu outlier/bad tick VN30F1M (phân tích chuyên sâu). Muốn học cách nhận diện dữ liệu nhiễu trước khi tin vào kết quả backtest? Đăng ký bản tin StockUp để nhận hướng dẫn xử lý dữ liệu chi tiết.
Bài viết liên quan
- Checklist Chất Lượng Dữ Liệu Lịch Sử VN30F1M
6 mục cần rà trước khi tin một bộ dữ liệu lịch sử VN30F1M đủ sạch để kiểm định chiến lược — từ outlier, look-ahead bias đến cách ghép chuỗi hợp đồng.
- Chuẩn Hoá Timestamp Dữ Liệu Tick VN30F1M
Ghép dữ liệu tick từ nhiều nguồn mà không chuẩn hoá timestamp có thể khiến tín hiệu giao dịch bị lệch thời điểm — đây là quy trình xử lý đúng cách.
- Lọc Bad Tick, Outlier Trong Dữ Liệu VN30F1M
Bad tick và outlier trong dữ liệu lịch sử VN30F1M có thể tạo tín hiệu giả cho backtest nếu không được nhận diện và xử lý đúng cách trước khi dùng.
- Xử Lý Phiên Nghỉ Lễ Trong Dữ Liệu Lịch Sử VN30F1M
Ngày nghỉ lễ và phiên giao dịch bất thường cần được xử lý nhất quán trong dữ liệu lịch sử VN30F1M — bỏ qua bước này có thể làm sai lệch kết quả kiểm định.
- Cách Tạo Nến Từ Dữ Liệu Tick VN30F1M Đúng Chuẩn
Gộp tick VN30F1M thành nến phút cần quyết định nhãn thời gian, phút trống, phiên ATO/ATC và nghỉ trưa. Các bước chuẩn và các lỗi làm nến lệch.
- Nguồn Dữ Liệu Lịch Sử VN30F1M Nào Đáng Tin?
So sánh dữ liệu lịch sử VN30F1M từ nguồn chính thức Sở/VSDC và nhà cung cấp thứ ba — độ đầy đủ, độ trễ, và cách kiểm tra chất lượng.